概要
量子アニーリングで使用される量子モンテカルロのようなアルゴリズムはFPGAなどのストリーム処理に実装するには擬似乱数などに一工夫必要です。
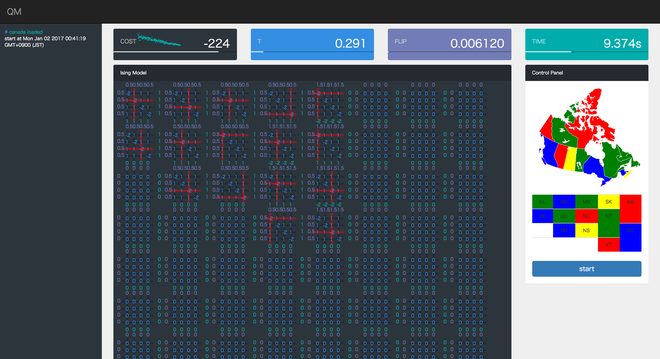
量子アニーリング on Apache Sparkはそもそも量子モンテカルロはSparkのようなRDD処理に向いているのかどうか含めて根本的に理論がないので自分たちで勉強して構築してみようというゆるい勉強会です。<<論文がカナダででたのでそれを参考にします。
場所について
場所は千代田区丸の内もしくは本郷三丁目ラボカフェを予定しています。
(17.6.30追記)場所が本郷三丁目ラボカフェになりました。
(17.8.2追記)人数を増やしました。
時間配分について
(17.8.11追記)
時間配分を調整しました。
18:30-19:00 概論
19:00-20:00 理論と実装
20:00-20:30 質疑と議論
論文について
(17.8.24追記)
直前ですが、論文を読みたいと思います。
Combinatorial Optimization by Decomposition on Hybrid CPU–non-CPU Solver Architectures
https://arxiv.org/abs/1708.03439
量子計算機と古典計算機のハイブリッド設計法に関することです。
今回は量子計算機ではなく、sparkを用いた並列化を検討しますが、
問題の分割方法は大変参考になるので、それを検討します。
また、量子アニーリングは様々なパラメータで並列化されており、
今回使用する量子モンテカルロ法を基本に、様々なアルゴリズムで速度検討をしている、
そしてパラレルテンパリングの提案などもありますので、こちらにも目を通したいと思います。
Effective optimization using sample persistence: A case study on quantum annealers and various Monte Carlo optimization methods
https://arxiv.org/abs/1706.07826
また、主催者はapache sparkにあまり明るくないので、金融計算+sparkでモンテカルロを使っている、clouderaのこちらの解説を参考にしたいと思います。
Estimating Financial Risk with Apache Spark
Learn how Spark facilitates the calculation of computationally-intensive statistics such as VaR via the Monte Carlo method.
VaRの計算とモンテカルロの量子モンテカルロは用途が違うので共通点が少ないかもしれませんが、
問題の並列化と乱数のシードをどのように管理するかを参考にしたいと思います。
https://blog.cloudera.com/blog/2014/07/estimating-financial-risk-with-apache-spark/


