
手元の機械で大規模言語モデルを動かすとき、どれだけのメモリが要るのかはMoEと量子化でLLMの必要メモリが変化、VRAMとホストRAMを分けて見る必要にで一次資料から整理しました。ただしそこでは、速度を確かめていません。公式の資料に実測が書かれていないためです。そこで、実際に測りました。この記事の数字は、断りのない限りすべて当サイトで測ったものです。
測った環境
| 項目 | 内容 |
|---|---|
| GPU | NVIDIA GeForce RTX 3090(VRAM 24GB) |
| ホストRAM | 503GB |
| CPU | 20コア相当 |
| 実行系 | llama.cpp(CUDA、sm_86向けに自前でビルド) |
| 測り方 | llama-bench(プロンプト512トークン、生成128トークン) |
同じ機械の上で構成だけを変えているので、機械の違いは入りません。
同じ質問を4つの構成に投げて、並べた
「量子コンピュータが従来のコンピュータと違う点を3つ、簡潔に説明してください」という同じ質問を、4つの構成に投げたときの様子です。録画した時刻をそのまま使っています。モデルの読み込みにかかる時間は機械の状態で変わるので除き、最初の1文字が出た時点をそろえました。
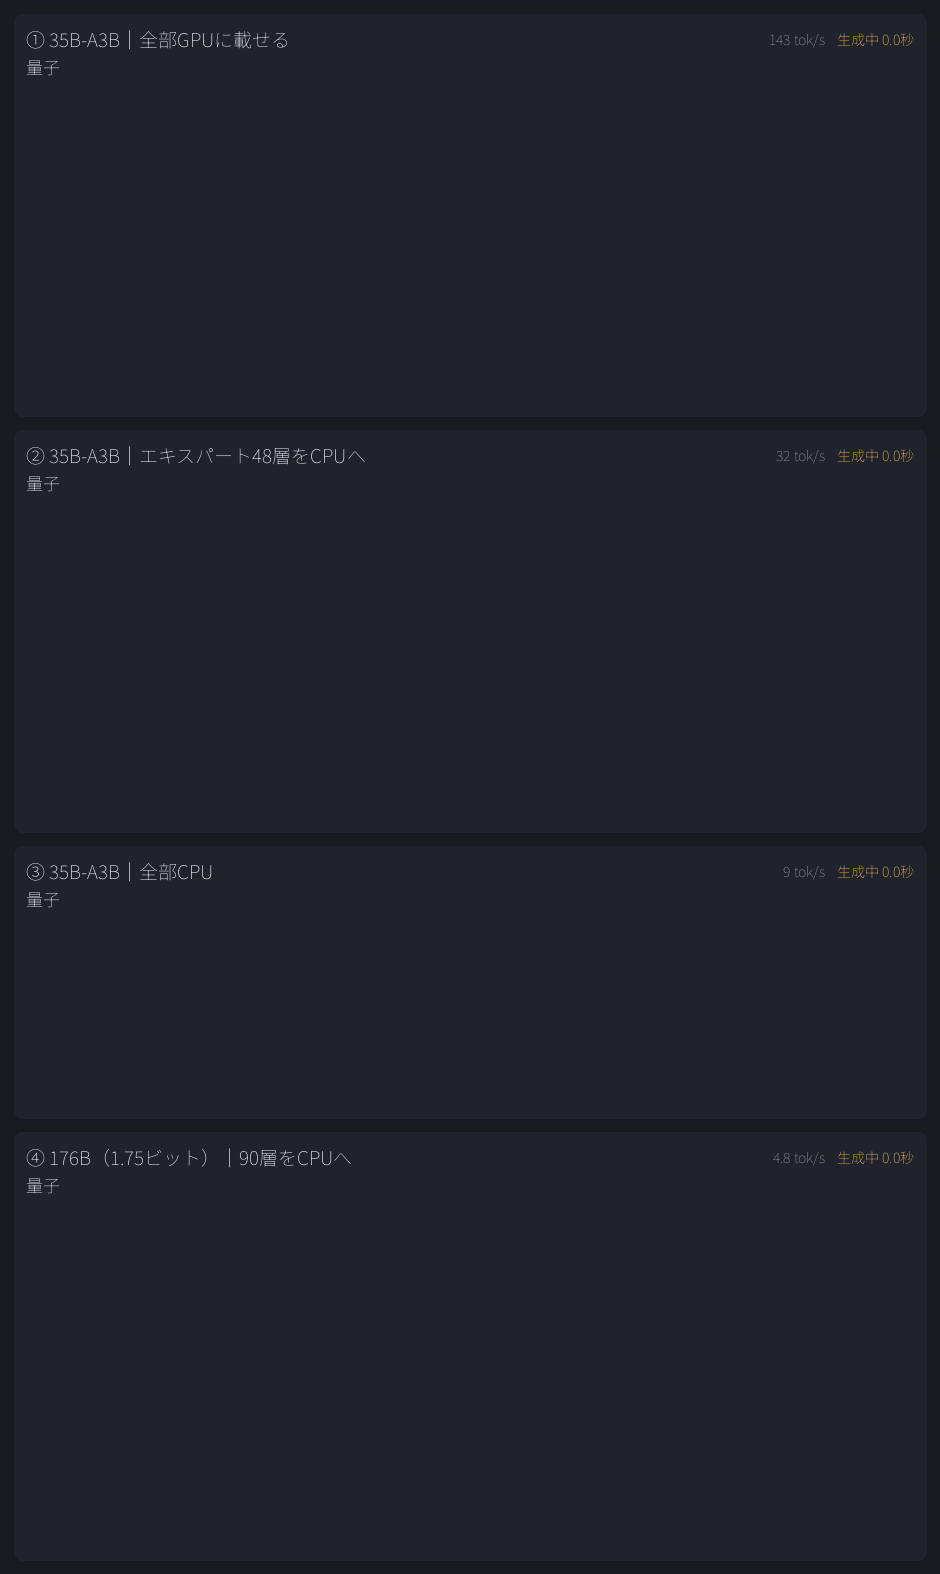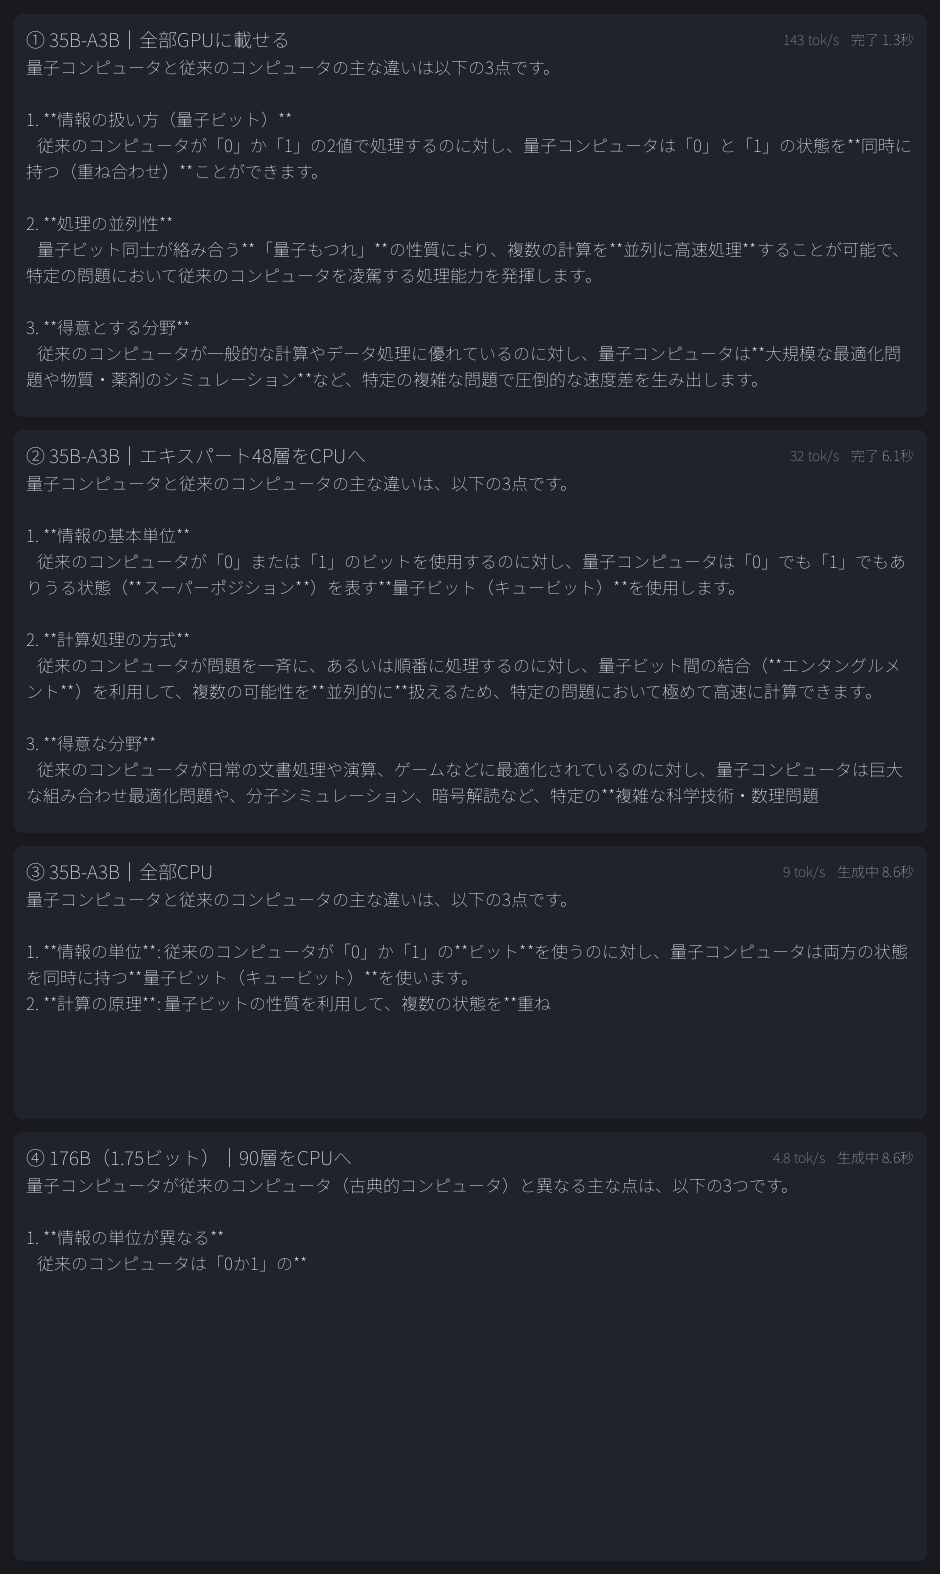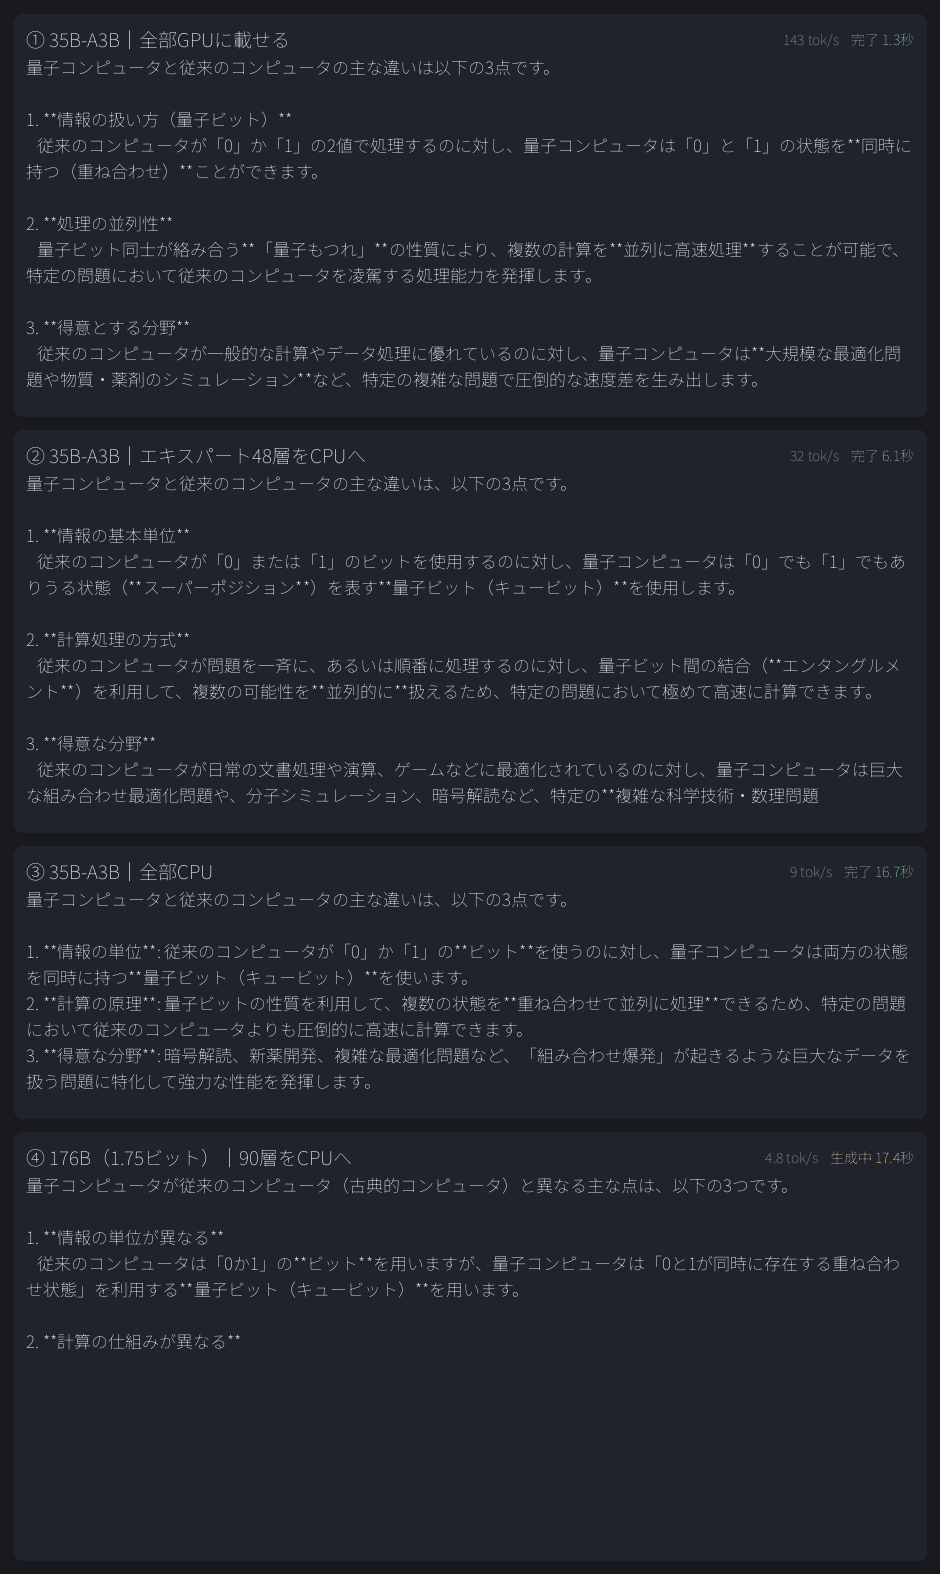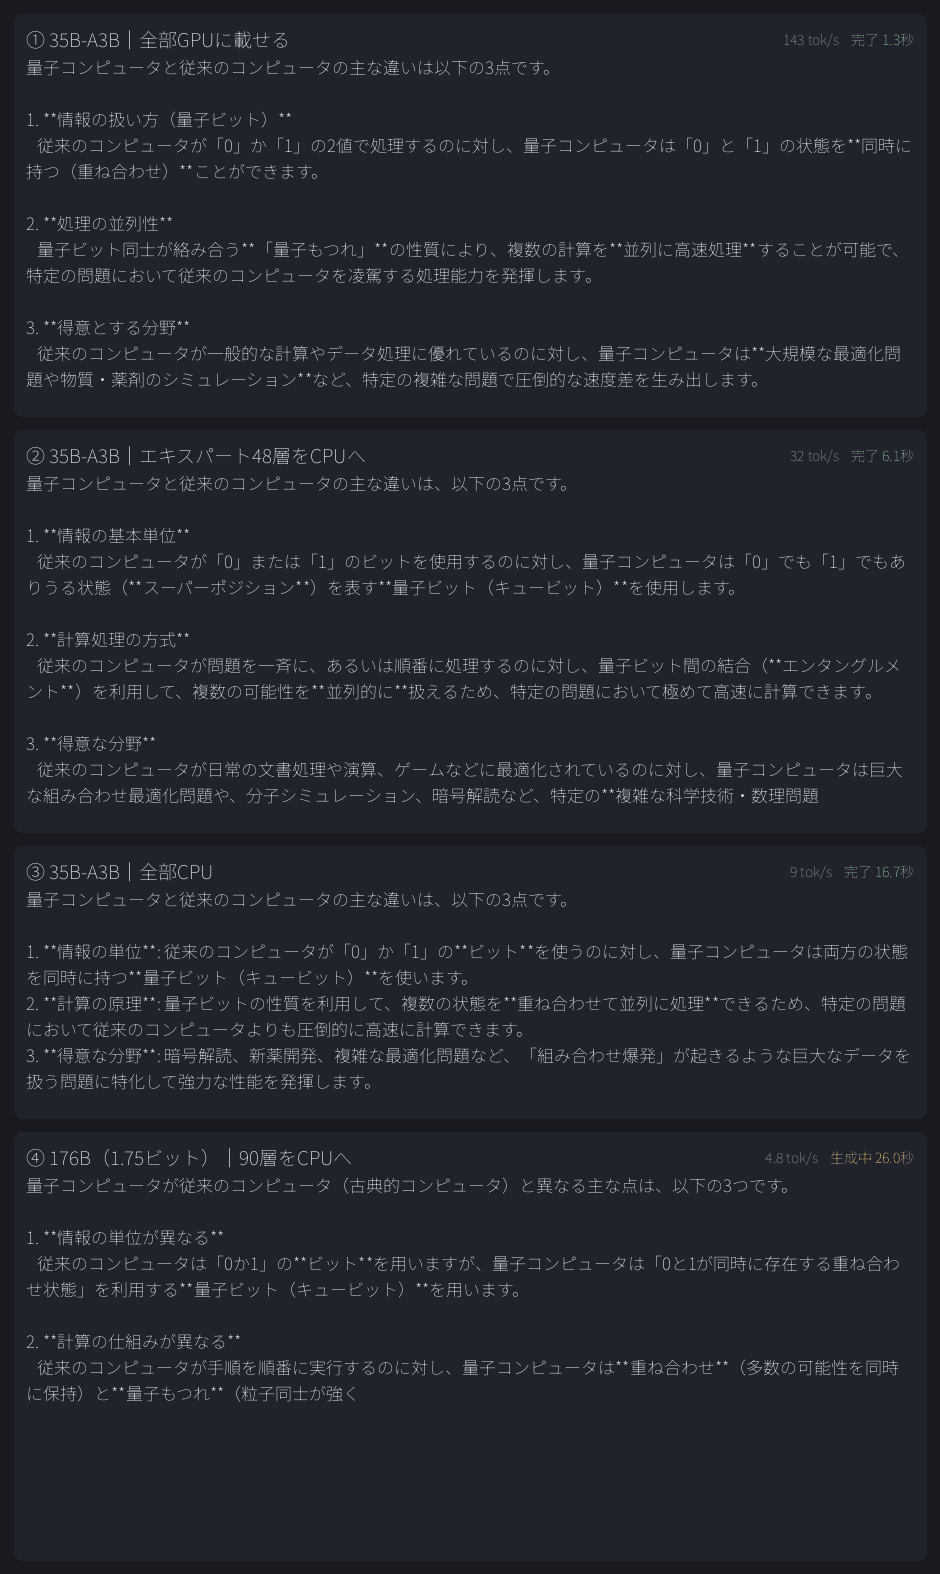
上の3つは同じモデル(35B-A3B)で、GPUに載せる量だけを変えています。いちばん下は176Bのモデルを1.75ビットまで削ったものです。全部GPUに載せた①は1.3秒で書き終わり、④は41.6秒かかりました。
エキスパートをCPUへ逃がすと、どこから遅くなるか
MoEのモデルは、動いていないエキスパートをCPU側のメモリに置いておけます。llama.cppでは --n-cpu-moe に層数を渡して指定します。Qwen3.6-35B-A3B(UD-Q4_K_M、20.60GiB)で層数を振ると、次のようになりました。
| CPUへ逃がす層数 | プロンプト処理 | 生成 |
|---|---|---|
| 0層(全部GPU) | 3086.77 | 150.12 |
| 8層 | 1278.55 | 78.39 |
| 16層 | 852.98 | 55.96 |
| 24層 | 648.69 | 42.77 |
| 48層 | 446.04 | 32.68 |
| 全部CPU | 365.33 | 9.22 |
単位はいずれも毎秒トークンです。最初の8層で半分になり、そこから先はゆるやかに落ちます。48層まで逃がしても32.68で、全部CPUの9.22とは3.5倍の差が残ります。
密なモデルと比べる
エキスパートを持たない密なモデルとして、Qwen3.8-27B(UD-Q4_K_M、15.32GiB)も測りました。
| 構成 | プロンプト処理 | 生成 |
|---|---|---|
| 全部GPU | 1155.24 | 35.84 |
| 全部CPU | 314.50 | 2.71 |
ここが今回いちばん面白いところです。35B-A3Bを48層もCPUへ逃がした状態(32.68)が、27Bの密なモデルを全部GPUに載せた状態(35.84)とほぼ並びます。パラメータの総数は35B対27Bで、逃がした側のほうが大きいのに、です。1トークンあたりに動く量が3Bしかないことが効いています。
176Bは、本流のllama.cppでは動かなかった
Qwen3.8-Flash-Nextの1.75ビット版(UD-IQ1_M、3ファイルで69.41GiB)を落としてきて読ませたところ、こうなりました。
llama_model_load: error loading model: unknown model architecture: 'qwen4exp'本流のllama.cppがこのアーキテクチャを知りません。手元のビルドが古いのかと思って確かめましたが、その日の最新のmasterと同じコミットでした。Unslothの配布ページには「動かすには私たちのllama.cpp PRを使ってください」と書かれており、指定されたPR #27742のブランチでビルドし直したところ読み込めました。
70GBを落としても、それだけでは動きません。モデルが公開された日と、それが手元で動くようになる日は別だということです。新しいアーキテクチャのモデルを試すときは、実行系が対応しているかを先に見たほうが、通信量を無駄にしません。
なお、llama-benchが表示するパラメータ数は176.94Bで、Qwen公式の125Bと食い違います。これは矛盾ではなく、2648で触れた51BのN-gram埋め込みを合わせて数えているためです(125B+51B)。
176Bは、層数を振っても速度が変わらない
| CPUへ逃がす層数 | プロンプト処理 | 生成 |
|---|---|---|
| 78層 | 277.74 | 4.76 |
| 82層 | 283.08 | 4.79 |
| 86層 | 285.47 | 4.81 |
| 90層 | 278.79 | 4.92 |
| 94層 | 278.57 | 5.04 |
| 全部CPU | 228.59 | 2.51 |
35B-A3Bでは層数が大きく効いたのに、ここではほとんど動きません。理由は単純で、69.41GiBのモデルに対してVRAMが24GBしかないからです。どう振っても大半の重みはCPU側にあり、GPUに載る分の増減が全体に響きません。35B-A3Bは20.60GiBで、そもそも全部がVRAMに収まる大きさでした。そこが分かれ目です。
それでも全部CPUの2.51に対しては2倍になっています。GPUが無駄なわけではありません。足りないだけです。なおこの6構成は時間の都合で1回ずつの測定なので、ばらつきは取れていません。
1.75ビットまで削っても、日本語は崩れなかった
速度だけを見て「24GBで176Bが動いた」と書くと、読む人を誤らせます。1ビット台まで削ったモデルは、速く動いても答えが壊れていることがあるためです。そこで出力も採りました。
3. **得意な計算領域が異なる**
   従来のコンピュータは一般的な日常業務や論理演算に優れますが、
   量子コンピュータは組み合わせ問題の最適化、暗号解読、分子(以下略)
日本語として成立しており、内容もおかしくありません。別の構成では「すべての計算で速くなるとは限りません」という留保まで書いていました。少なくとも短い受け答えの範囲では、崩れませんでした。長い文章や、込み入った指示でどうなるかは確かめていません。
では、毎秒何トークンあれば足りるのか
毎秒150トークンと言われても、それが速いのかどうかは分かりません。読む速さと比べられる形にします。
まず、1トークンが日本語の何文字にあたるかを、上の4本の録画から数えました。太字を表す記号などは外し、読む人が実際に目にする文字だけを数えています。
| 構成 | 生成速度 | 出た文字数 | かかった秒数 | 1トークンあたり |
|---|---|---|---|---|
| 全部GPU | 143.1 | 318字 | 1.30秒 | 1.71字 |
| 48層をCPUへ | 32.4 | 354字 | 6.13秒 | 1.78字 |
| 全部CPU | 9.0 | 271字 | 16.62秒 | 1.81字 |
| 176B | 4.8 | 334字 | 41.60秒 | 1.67字 |
4本とも1.7字前後でそろいました。1トークンが日本語およそ1.7文字として換算できます。これはモデルとトークナイザによって変わる数字なので、他のモデルにそのまま当てはまるとは限りません。
この換算で、読む速さに追いつくのに要る生成速度は次のようになります。
| 読む速さ | 追いつくのに要る生成速度 |
|---|---|
| 300字/分 | 毎秒2.9トークン |
| 400字/分 | 毎秒3.9トークン |
| 600字/分 | 毎秒5.9トークン |
| 800字/分 | 毎秒7.8トークン |
| 1,000字/分 | 毎秒9.8トークン |
読む速さは人によって差が大きく、日本語の平均値として広く合意された数字を、当サイトでは一次資料にあたって確かめられませんでした。そのため上の表は換算だけを示しています。ご自分の速さを当てはめてご覧ください。声に出して読むと1分あたり300字前後、黙って読むとその倍以上になる、というあたりが手がかりになります。
ここから、実際の使い心地について3つ言えます。
毎秒5トークン前後は、ちょうど読む速さと同じくらいです。今回の176Bがここでした。止まって見えるわけではありませんが、余裕もありません。文字が出るのを追いかける形になり、先に目を走らせて要らない段落を飛ばす、といったことができません。実際、同じ内容を書き終えるのに41.6秒かかっています。
毎秒30トークン前後になると、読む速さの5倍ほどです。今回で言えば、35B-A3Bのエキスパートを48層CPUへ逃がした構成がここでした。段落がまとまって出てくるので、普通の読み書きのやりとりで待たされることはありません。24GBのGPUで実用になる帯はこのあたりです。
毎秒100トークン以上が効くのは、長い文章を一度に出させるときや、何度も書き直させるときです。読む速さの20倍あっても、300行のプログラムを出すあいだは待つことになります。読んで確かめるより先に、次を出させたい使い方をするなら、ここが要ります。
外部の測定と照合する
自分の測定だけでは、機械の当たり外れを見分けられません。同じGPUと同じモデルの報告を探しました。
Giles Thomas氏が2026年7月24日に公開した測定によると、RTX 3090でQwen3.6-35B-A3B(UD-IQ4_NL_XL、19.5GiB)をCUDAで動かし、全部GPUで毎秒139.6トークン、10層をCPUへ逃がして毎秒89.1トークンとされています。当サイトの測定はUD-Q4_K_M(20.60GiB)で全部GPUが150.12、8層で78.39でした。量子化の種類が違うので厳密には比べられませんが、同じ機械で同じくらいの数字が出ています。別々に測って揃ったので、桁を間違えてはいないと考えています。
まとめ
24GBのGPU1枚で言えることは、次の3つです。
第一に、MoEのモデルは、全部をVRAMに載せられる大きさなら、かなり逃がしても速い。35B-A3Bは48層をCPUへ逃がしても毎秒32.68トークンで、27Bの密なモデルを全部GPUに載せたのと同じくらいでした。
第二に、VRAMに収まらない大きさになると、逃がし方を工夫しても効かない。176Bでは層数をどう振っても毎秒5トークン前後で、変わりませんでした。
第三に、動くことと使えることは別です。1.75ビットまで削れば176Bは24GBで動き、日本語も崩れませんでした。ただし速度は読む速さと同じくらいで、余裕はありません。
必要なメモリについてはMoEと量子化でLLMの必要メモリが変化、VRAMとホストRAMを分けて見る必要に、モデルの作りが変わってきた流れについてはAIトレンド①モデルの作りが変わった―大きさより「1回にいくつ動かすか」、今回使ったGGUF版の公開についてはUnsloth、Qwen3.8-Flash-Nextを75GBのRAMで動かすGGUF版を公開もあわせてご覧ください。


