
RTX 3090でLLMを実測―毎秒何トークンあれば読む速さに足りるかと同じ測定を、別の機械でもう一度行いました。狙いはGPUの世代比較ではありません。生成速度がGPUで決まるのか、CPUで決まるのかを切り分けることです。
そもそも、GPUとCPUで計算を分け合うのは普通のやり方ではありません。モデルがVRAMに収まるなら、全部GPUに載せるのがいちばん速い。分担させるのは、収まりきらないときのやむを得ない手です。そして近ごろのモデルは大きく、収まらないほうが当たり前になってきました。
結果を先に書きます。収まるうちはGPUが効き、収まらなくなってエキスパートをCPUへ逃がした瞬間、GPUの差は消えます。
この比較の前提と限界
先に断っておきます。今回の2台は、GPUとCPUの両方が違います。しかも向きが逆です。
| 項目 | 機械A | 機械B |
|---|---|---|
| GPU | RTX 3090 / VRAM 24GB | RTX 5090 / VRAM 32GB |
| ホストCPU | 20コア相当 | AMD EPYC 9B14 の割り当て52.7CPU分 |
| ホストRAM | 503GB | 755GB |
| 実行系 | llama.cpp(CUDA) | llama.cpp(CUDA 12.8、sm_120向け) |
| 測り方 | llama-bench(プロンプト512、生成128) | 同じ |
機械BのほうがGPUは新しく、CPUは実測で約半分の速さでした。コア数の表示は機械Bのほうが多いのに、です。利用したGPU環境では、GPUを選んでもCPUまでは選べません。
したがって、この記事の数字を「RTX 3090対RTX 5090」として読まないでください。GPUの世代差として使えるのは、モデルがすべてVRAMに載る行だけです。それ以外の行は、2台の釣り合いの違いを見るためのものです。数字はすべて当サイトで測ったものです。速度は毎秒トークン数で表します。
全部VRAMに載る構成では、GPUの差がそのまま出る
単位は毎秒トークン数(1秒間に作れるトークンの数)。多いほど速い。
| 構成 | 機械A(3090) | 機械B(5090) | 機械B ÷ 機械A |
|---|---|---|---|
| 27B 密・生成 | 35.84 | 80.89 | 2.26倍 |
| 27B 密・プロンプト処理 | 1155.24 | 3797.48 | 3.29倍 |
| 35B-A3B・生成 | 150.12 | 263.68 | 1.76倍 |
| 35B-A3B・プロンプト処理 | 3086.77 | 8399.36 | 2.72倍 |
ここはCPUがほとんど働かないので、GPUの差として読めます。生成が1.8〜2.3倍、プロンプト処理が2.7〜3.3倍でした。
伸び方が違うのには理由があります。生成は1トークンごとにモデルの重みを読み直す作業なので、メモリの帯域がそのまま効きます。プロンプト処理は計算量が支配的なので、演算器が増えた分も乗ります。同じGPUを替えても、何をさせるかで伸び方が変わります。27Bの生成は3回測って80.61、80.80、80.89と揃いました。
エキスパートをCPUへ逃がした瞬間、逆転する
単位は毎秒トークン数(1秒間に作れるトークンの数)。多いほど速い。
| CPUへ逃がす層数 | 機械A(3090) | 機械B(5090) | 機械B ÷ 機械A |
|---|---|---|---|
| 0層(全部GPU) | 150.12 | 263.68 | 1.76倍 |
| 8層 | 78.39 | 44.14 | 0.56 |
| 16層 | 55.96 | 32.60 | 0.58 |
| 24層 | 42.77 | 23.13 | 0.54 |
| 48層 | 32.68 | 16.37 | 0.50 |
| 全部CPU | 9.22 | 2.96 | 0.32 |
8層逃がしただけで、1.76倍が0.56へ反転します。逃がす層を増やすほど、比は0.50に近づきます。
これはGPUの話ではありません。逃がした計算はCPUがやるので、GPUがどれだけ新しくても関係がなくなるということです。比が0.47から0.58の狭い範囲に揃っていることが、その裏づけになります。ばらつきなら、こうはそろいません。
ここで効くのはCPU側のメモリ帯域です。MoEのエキスパート計算は重みを読む作業が主だからです。実際、スレッド数を割り当てに合わせて絞ったところ、かえって遅くなりました(既定15.6に対し、52スレッドで7.04)。演算器の数ではなく、同時にどれだけメモリを読みに行けるかが効いている、と考えられます。
VRAMに収まりきらないモデルでは、また向きが変わる
69.41GiBある176Bのモデルでは、こうなりました。
単位は毎秒トークン数(1秒間に作れるトークンの数)。多いほど速い。
| CPUへ逃がす層数 | 機械A(3090) | 機械B(5090) | 機械B ÷ 機械A |
|---|---|---|---|
| 78層 | 4.76 | 7.93 | 1.67倍 |
| 86層 | 4.81 | 8.50 | 1.77倍 |
| 94層 | 5.04 | 8.11 | 1.61倍 |
| 全部CPU | 2.51 | 1.41 | 0.56 |
CPUが半分の速さの機械Bが、1.7倍速くなりました。
このモデルは24GBにも32GBにも収まりません。どちらも大半をCPU側に置きますが、GPUが担当できる割合が24GBと32GBで1.33倍違います。35B-A3Bは20.60GiBで元から全部載る大きさだったので、逃がした時点でCPUの性能がそのまま出ました。176Bは最初から載りきらないので、VRAMが増えた分だけGPUの担当が増えて効いた、という説明になります。
全部CPUの行(1.41)だけは比が0.56に戻ります。GPUを使わなければ、やはりCPUの差が出ます。
同じ質問を投げて、並べたもの
同じ質問を2台に投げ、文字が出てくる様子を実時間で並べました。モデルの読み込み時間は機械の状態で変わるので除き、最初の1文字が出た時点をそろえています。
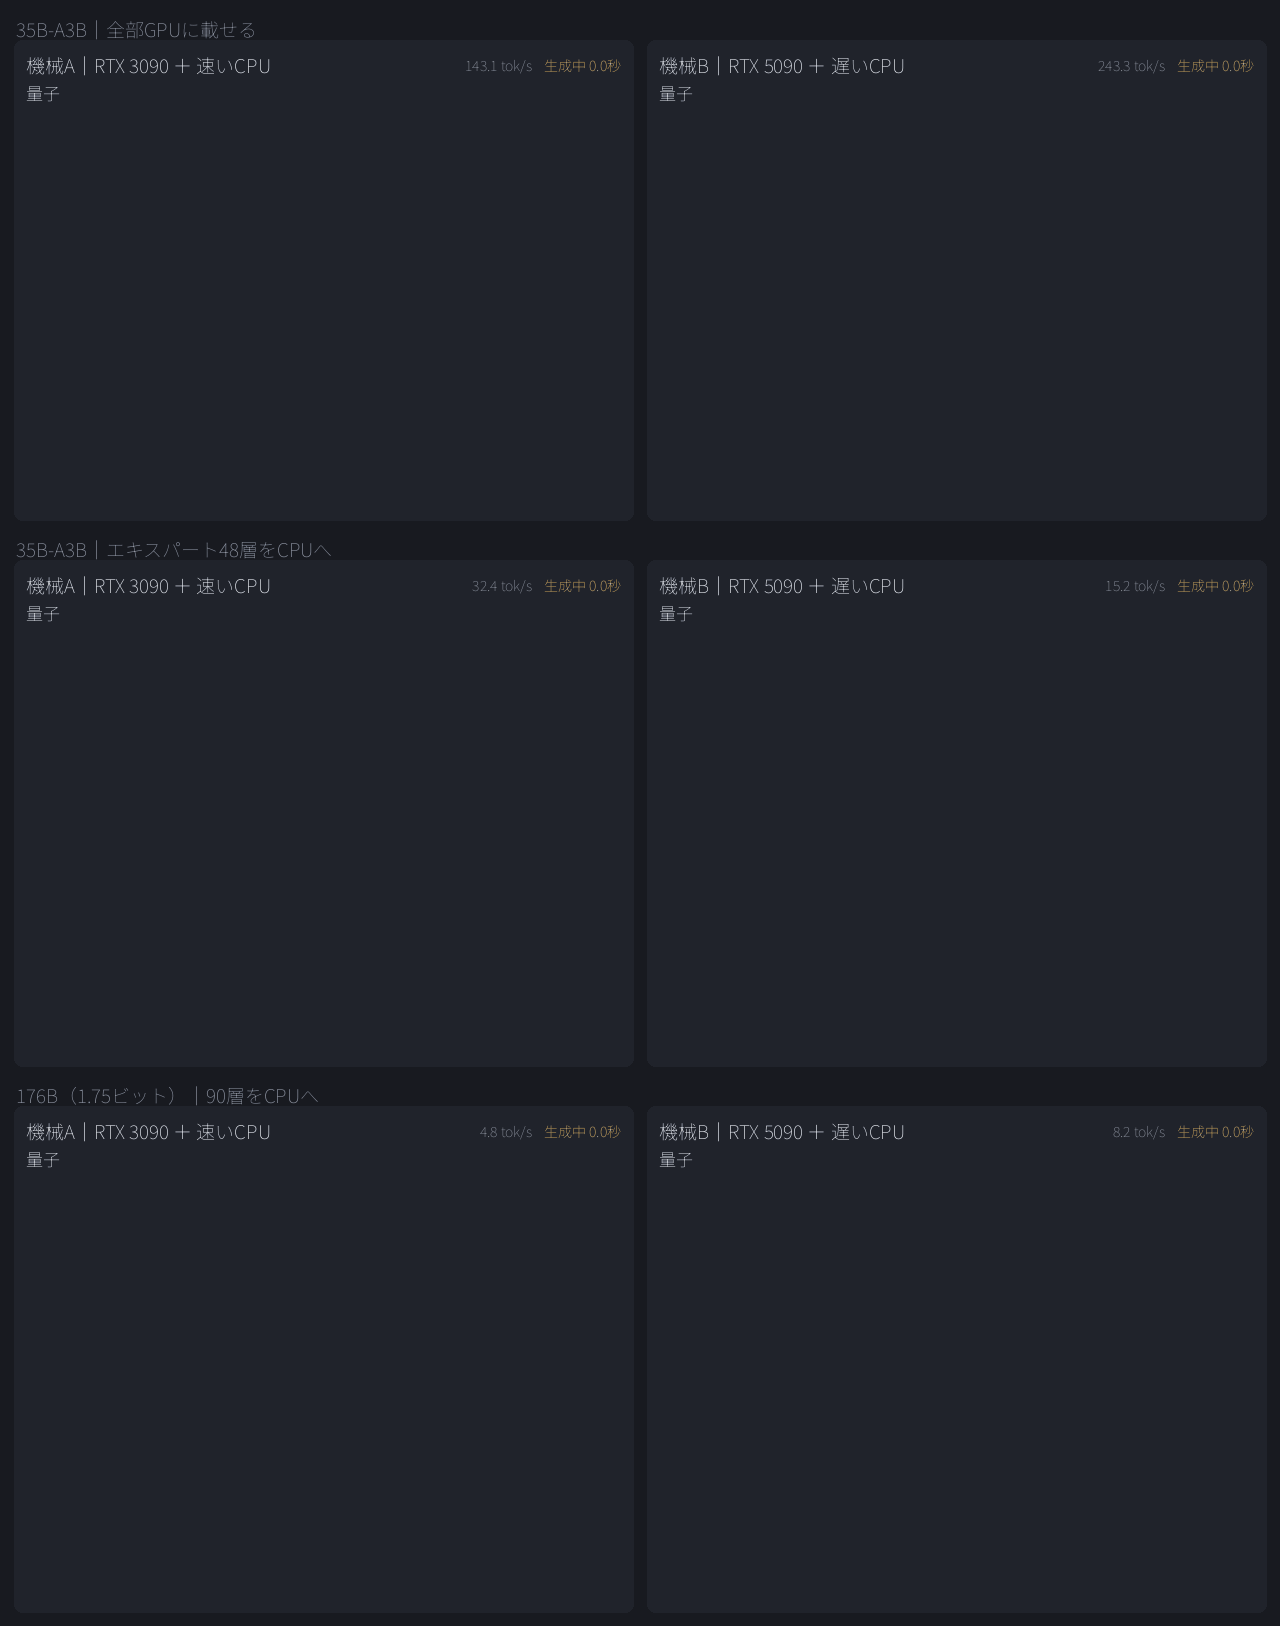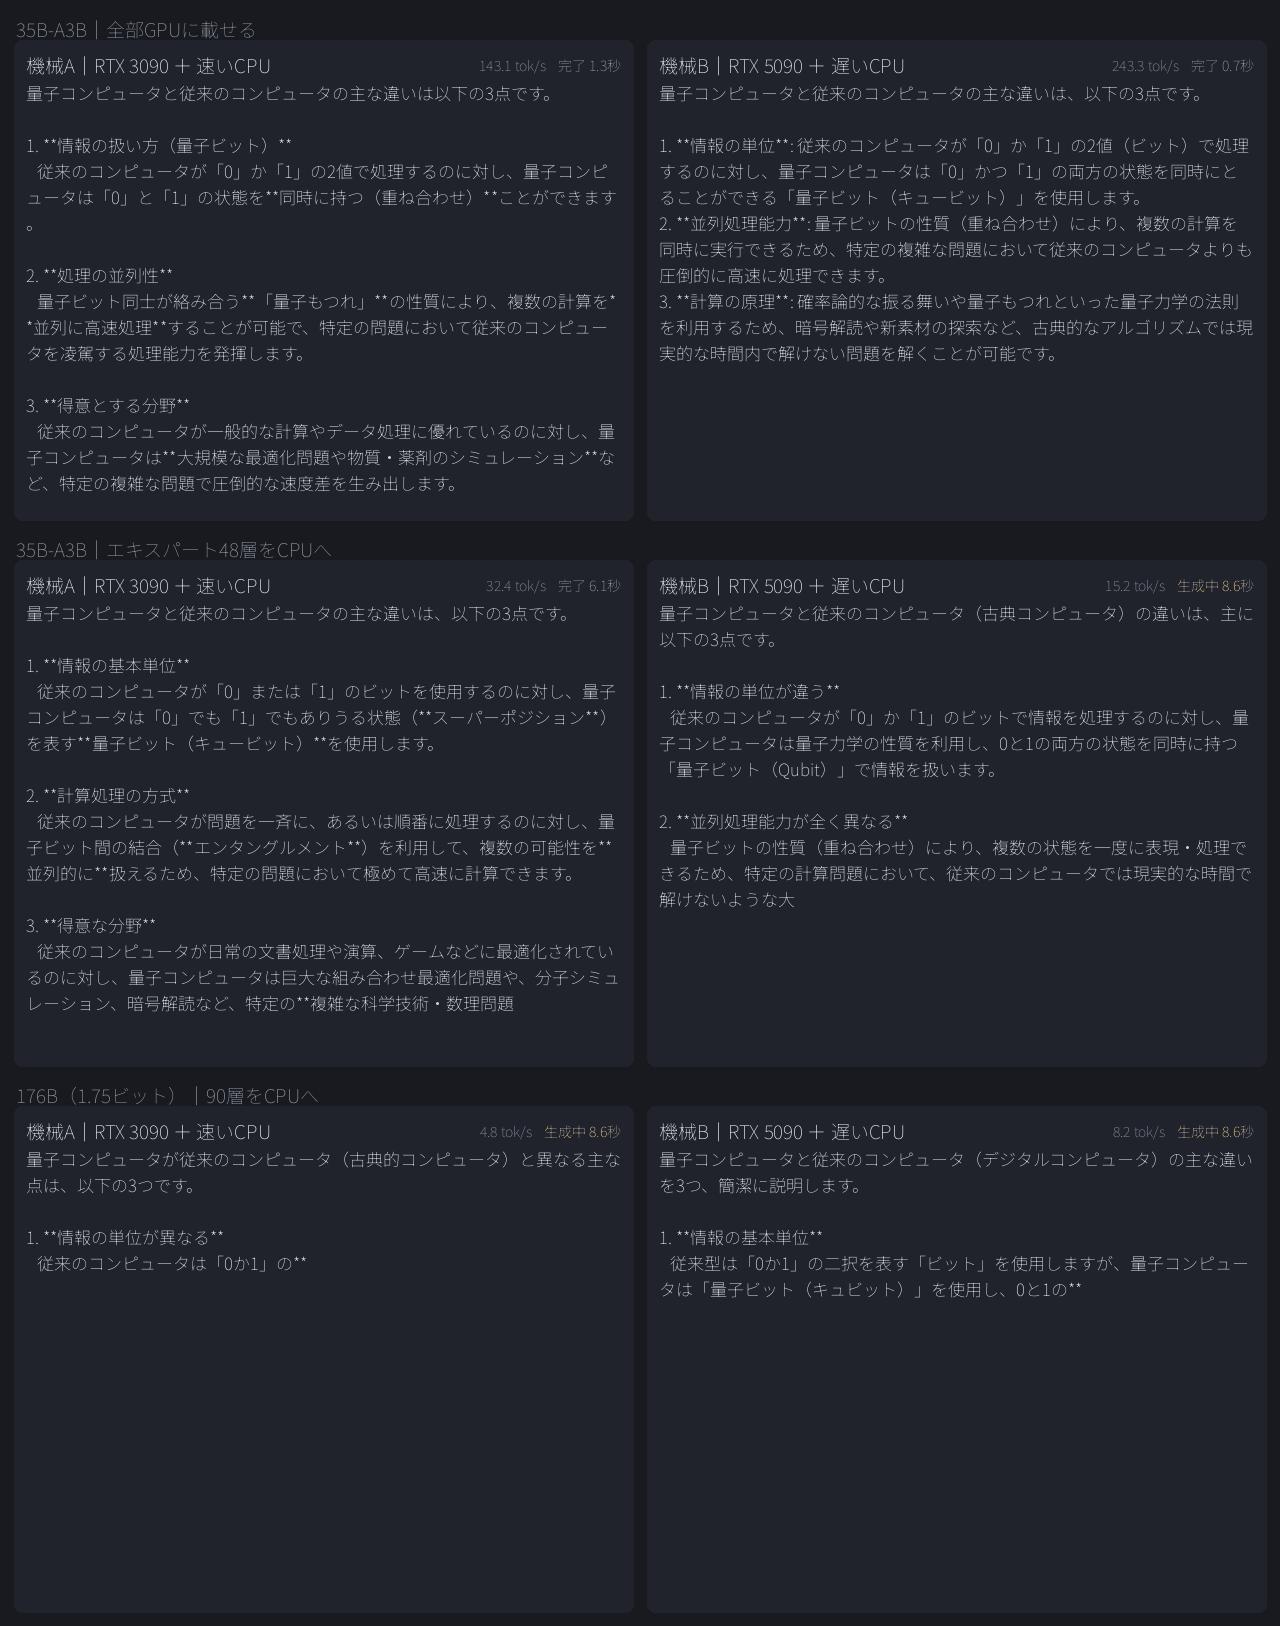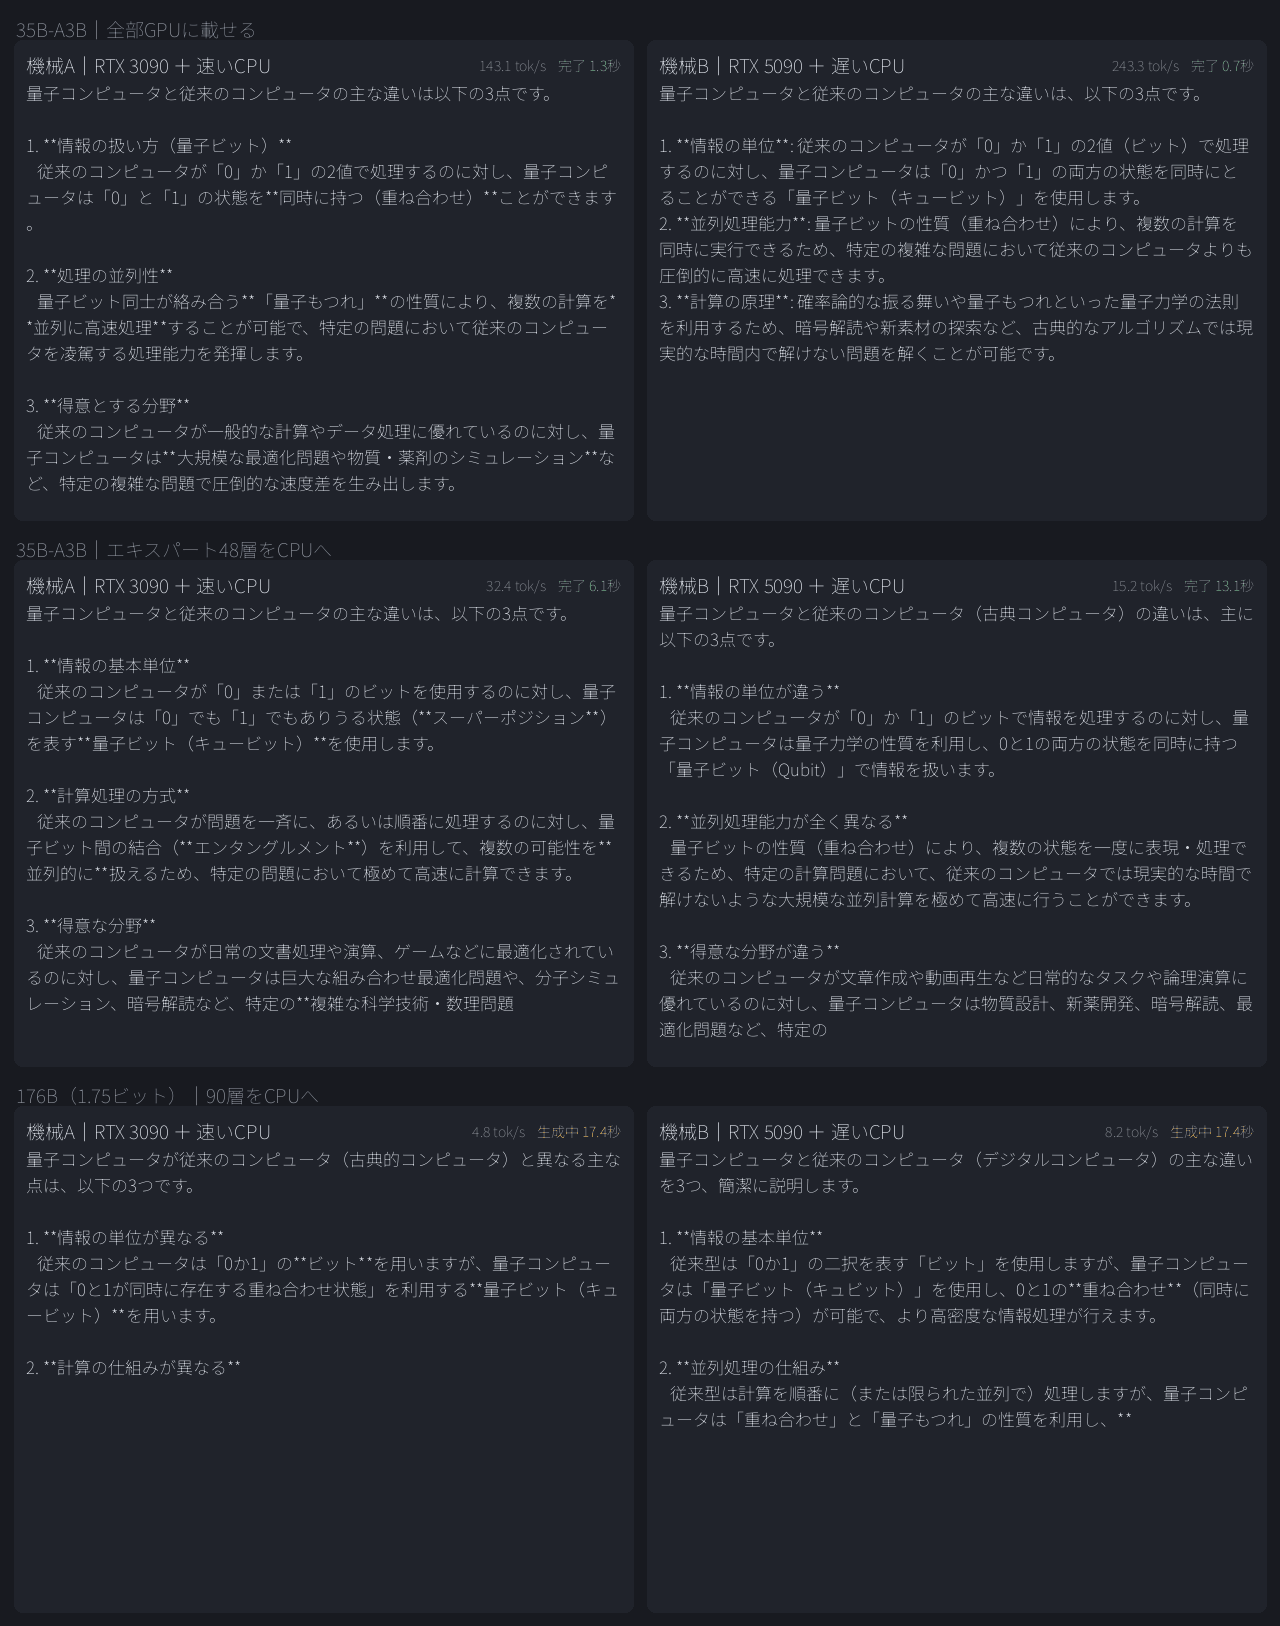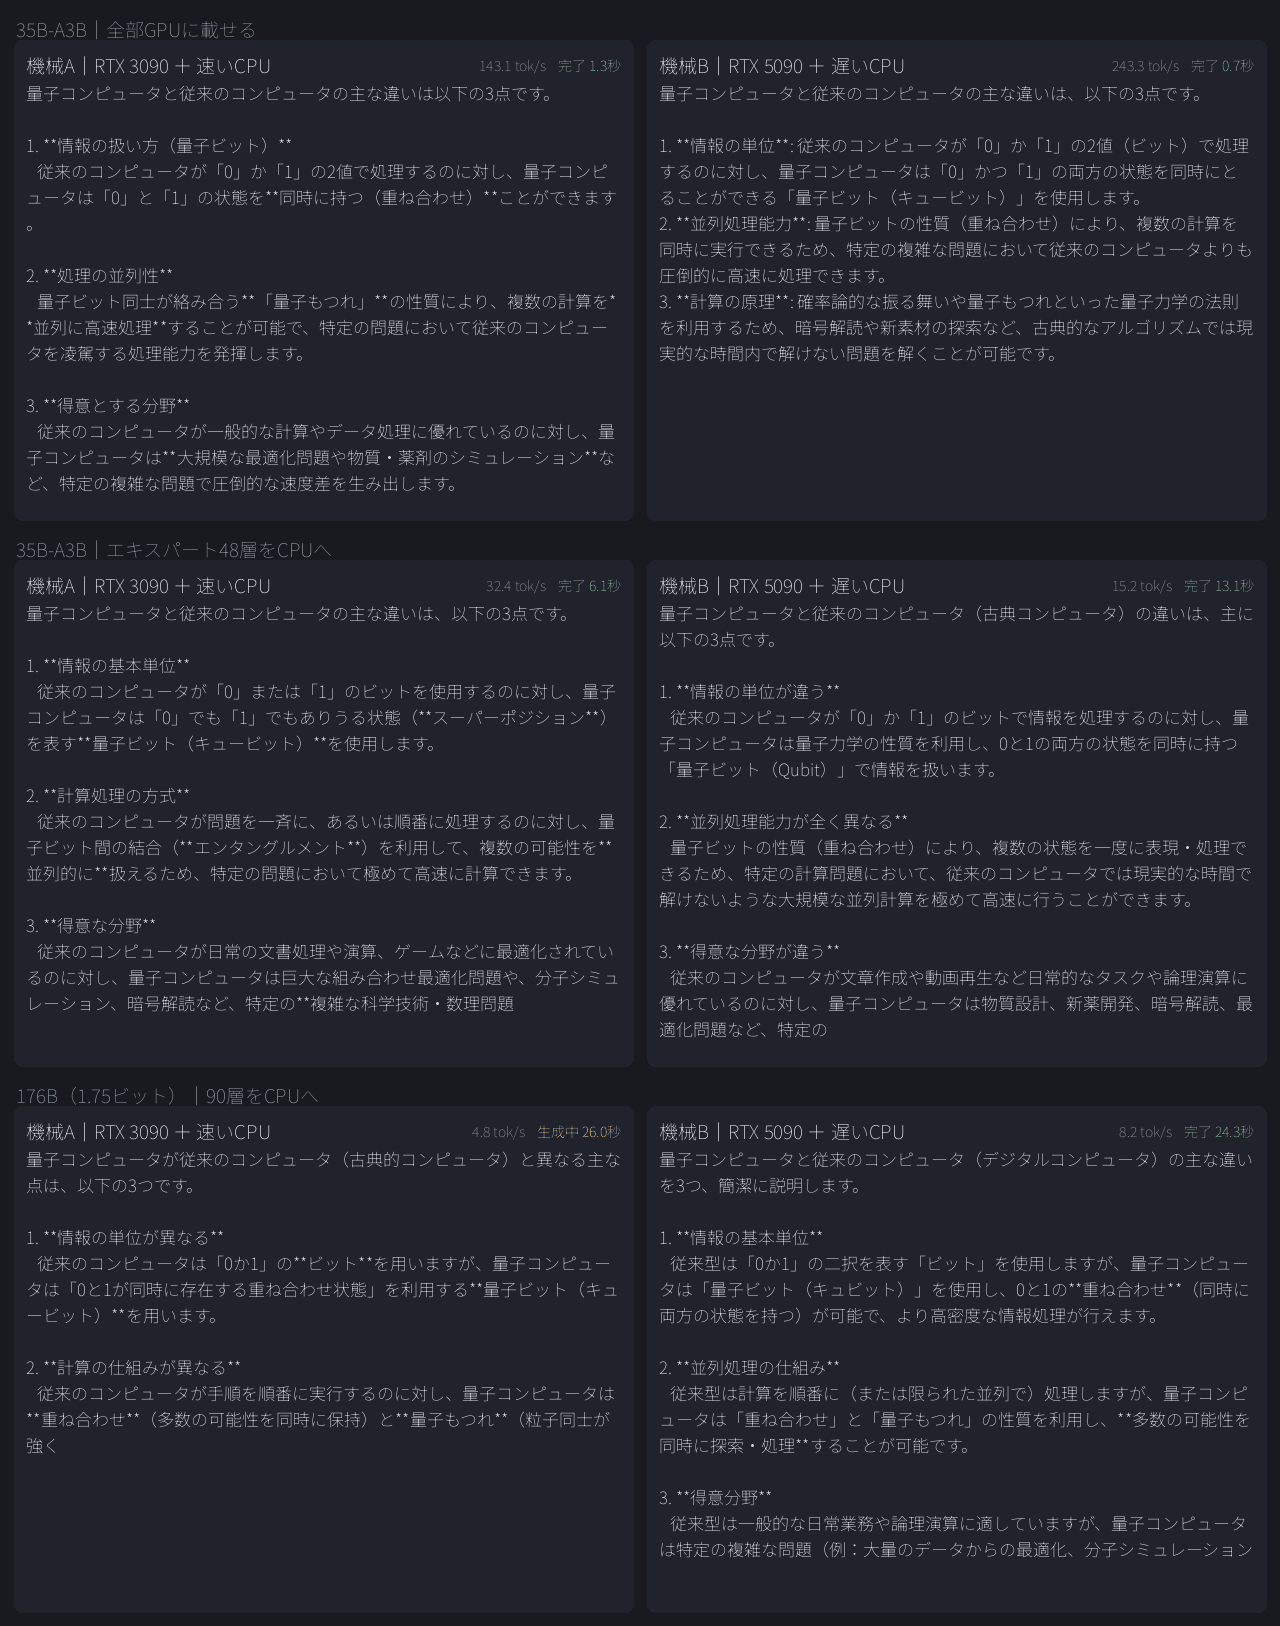
上段で機械Bが勝ち、中段で負け、下段でまた勝ちます。同じ2台なのに、何を動かすかで勝ち負けが入れ替わる。これがこの記事で伝えたいことです。
釣り合いをどう見ればよいか
モデルがVRAMに全部収まるなら、GPUを見てください。27Bで2.26倍、35B-A3Bで1.76倍の差が出ました。CPUはほとんど関係しません。
収まらず、エキスパートをCPUへ逃がすなら、GPUを新しくしても効きません。35B-A3Bを48層逃がした構成では、GPUが新しいほうが半分の速度でした。ここで見るべきはCPU側のメモリ帯域です。
収まらないが、VRAMを増やせば載る割合が増える場合は、VRAMの量が効きます。176BではCPUが半分でも、VRAMが8GB多いほうが1.7倍速くなりました。
つまり、先に決まるのはモデルの大きさとVRAMの関係で、そこからGPUを見るのかCPUを見るのかが決まります。GPUの型番だけを見て選べる話ではなくなっています。
1.75ビットと4ビットで、速度はほとんど変わらなかった
もうひとつ確かめたことがあります。176Bで使ったのは1.75ビットまで削ったUD-IQ1_M(69.41GiB)でした。この方式はCPUで元に戻す処理が重いため、それが遅さの原因ではないかと考え、4ビットのUD-Q4_K_XL(103.68GiB)でも測りました。同じ機械Bです。
単位は毎秒トークン数(1秒間に作れるトークンの数)。多いほど速い。
| CPUへ逃がす層数 | UD-IQ1_M(1.75ビット・69.41GiB) | UD-Q4_K_XL(4ビット・103.68GiB) |
|---|---|---|
| 94層 | 8.11 | 7.84 |
| 90層 | ― | 7.85 |
| 86層 | 8.50 | 7.81 |
| 80層 | ― | 7.36 |
| 70層 | ― | 7.62 |
ほとんど変わりません。34GB大きくなっても速度が同じということは、律速は展開の計算ではなく、CPU側でどれだけ速く重みを読めるかだということです。粗く削れば速くなる、という直感は当たりませんでした。容量を減らす意味はメモリに載せるためであって、速度のためではありません。
なお、同じ4ビット構成で毎秒21トークンという第三者の報告がありますが、当サイトでは再現できませんでした。相手より多いVRAM(32GB対24GB)で7.8です。実行系が違う可能性がありますが、確かめられていません。
新しいGPUを使うときの注意
機械BのRTX 5090はBlackwellという世代で、GPUの型番はsm_120です。llama.cppをそのままビルドしても動きません。CUDA 12.8以上を用意し、-DCMAKE_CUDA_ARCHITECTURES=120 を渡してビルドし直す必要があります。176Bのモデルが本流のllama.cppでは読み込めずUnslothのPRブランチが必要だったのと同じで、新しいものを試すときは実行系が追いついているかを先に確かめたほうが、無駄がありません。
測るときに踏んだ落とし穴
原因の見当を3回外しました。どれももっともらしく聞こえたのに、測ったら違いました。
外した見立て① スレッド数の取りすぎ。機械Bの表示上のスレッド数は384ですが、実際の割り当ては52.7CPU分でした。取りすぎで遅いのだと考えて絞ったところ、かえって遅くなりました。既定のままが15.6、52スレッドで7.04、16スレッドで8.78です。
外した見立て② 機械が混んでいた。利用した機械は他の利用者と同居します。それが原因かと思い同じ条件で測り直しましたが、14.86、15.77、15.62と再現しました。混雑のせいではありませんでした。
外した見立て③ 量子化の選び方。上に書いたとおり、4ビットにしても変わりませんでした。
正解は、機械BのCPUが約半分の速さだったというだけです。測らずに書いていたら、3回とも間違ったことを書いていました。
もうひとつ、恥ずかしい失敗も記しておきます。前の測定スクリプトが終わらないまま次を走らせてしまい、2本が同じCPUとGPUを取り合った状態の数字を一度出しました。気づいて捨て、ロックファイルを使う形に直しました。こうした環境での測定は、足元の確認に時間の大半が要ります。
まとめ
生成速度はGPU単体では決まりません。モデルがVRAMに収まるかどうかで、GPUとCPUのどちらが効くかが入れ替わります。収まるならGPU、収まらずCPUに任せるならCPU側のメモリ帯域、収まりきらないが載る割合を増やせるならVRAMの量です。
今回の2台はGPUが新しいほうがCPUは遅く、構成ごとに勝ち負けが入れ替わりました。GPUの世代比較としては公正な組み合わせではありませんが、釣り合いが崩れた機械では何が起きるかを見るには、かえって都合の良い材料になりました。
必要なメモリの考え方についてはMoEと量子化でLLMの必要メモリが変化、VRAMとホストRAMを分けて見る必要に、毎秒何トークンあれば読む速さに足りるかについてはRTX 3090でLLMを実測―毎秒何トークンあれば読む速さに足りるかもあわせてご覧ください。


