
RTX 3090でLLMを実測―毎秒何トークンあれば読む速さに足りるかでは24GBのGPUで176Bのモデルが毎秒5トークンでした。VRAMに載らずGPUとCPUで分担させるとき、速度を決めるのはCPUでは、計算をCPUへ逃がした瞬間にGPUの新しさが効かなくなることを確かめました。
どちらも「モデルがVRAMに収まらない」ことが前提の話です。今回は収まる場合を測りました。VRAM 96GBのGPUを使い、300B級のモデルをCPUに1層も逃がさずに動かしています。数字はすべて当サイトで測ったものです。
測った環境
| 項目 | 内容 |
|---|---|
| GPU | NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition |
| VRAM | 97,887 MiB(約96GB) |
| ホストRAM | 1,512GB |
| 実行系 | llama.cpp(CUDA 12.8、sm_120向けに自前でビルド) |
| 測り方 | llama-bench(プロンプト512、生成128、3回) |
300B級が丸ごと載る
単位は毎秒トークン数(1秒間に作れるトークンの数)。多いほど速い。
| モデル | 総パラメータ | ファイル | 生成 | プロンプト処理 | VRAM最大 |
|---|---|---|---|---|---|
| Qwen3.8-Flash-Next(3ビット) | 176.94 B | 83.80 GiB | 79.59 | 2416.99 | 57.6 GiB |
| DeepSeek-V4-Flash-0731(1.75ビット) | 284.33 B | 80.93 GiB | 68.40 | 1217.82 | 81.7 GiB |
| GLM-5.3-Flash(1.75ビット) | 320.76 B | 90.87 GiB | 66.97 | 921.64 | 89.2 GiB |
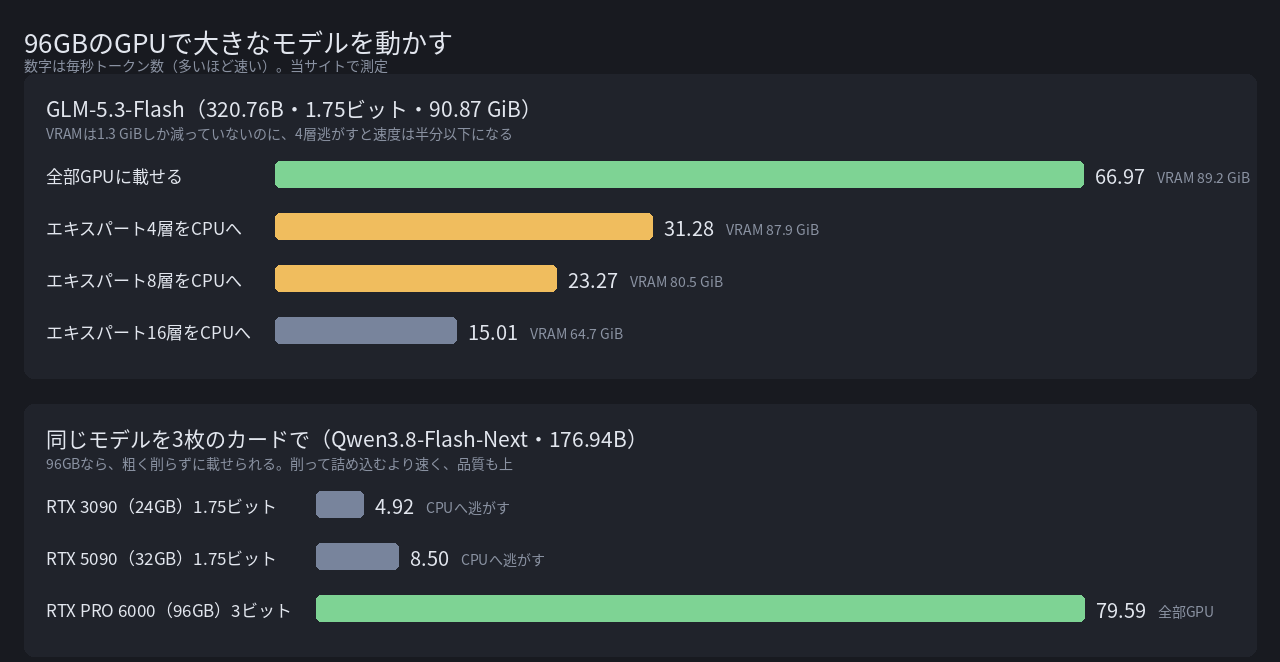
320Bのモデルが毎秒67トークンです。24GBのGPUでは176Bですら4.92でした。
ひとつ、当サイトの見立てが外れた点を書いておきます。GLM-5.3-Flashの配布ファイルは97.6GBで、96GBのGPUには入らないと予想していました。実際には入りました。VRAM使用量の最大は89.2 GiBです。配布ファイルの容量が、そのままVRAM使用量になるわけではありません。
4層逃がすだけで、半分以下になる
ここが今回いちばん実用に効く結果です。GLM-5.3-Flashで、CPUへ逃がすエキスパートの層数を変えました。
| 構成 | 生成 | プロンプト処理 | VRAM最大 |
|---|---|---|---|
| 全部GPU | 66.97 | 921.64 | 89.2 GiB |
| エキスパート4層をCPUへ | 31.28 | 782.16 | 87.9 GiB |
| エキスパート8層をCPUへ | 23.27 | 528.92 | 80.5 GiB |
| エキスパート16層をCPUへ | 15.01 | 324.37 | 64.7 GiB |
4層逃がしただけで、66.97が31.28になります。半分以下です。そしてそのときVRAMは89.2から87.9 GiBへ、1.3 GiBしか減っていません。
つまり、ほんのわずかVRAMが足りないだけで、速度は半分になります。「あと2GBあれば全部載るのに」という状態が、いちばん割に合いません。機材を選ぶときは、ぎりぎり載る構成ではなく、余裕を持って載る構成を選ぶべきだ、ということになります。
DeepSeek-V4-Flashではもっと急でした。16層逃がすと68.40から3.93へ、17分の1です。モデルが大きいほど1層あたりの重みが重くなるためと考えられます。
同じモデルを3枚のカードで追う
Qwen3.8-Flash-Nextを、3回の測定を通して同じ条件で比べられます。
| カード | VRAM | 量子化 | 生成 |
|---|---|---|---|
| RTX 3090 | 24GB | 1.75ビット | 4.92 |
| RTX 5090 | 32GB | 1.75ビット | 8.50 |
| RTX PRO 6000 | 96GB | 3ビット | 79.59 |
粗く削って24GBに詰め込むより、精度を上げたまま96GBに載せるほうが16倍速く、しかも品質は上です。
VRAMに載らずGPUとCPUで分担させるとき、速度を決めるのはCPUで「1.75ビットと4ビットで速度はほとんど変わらなかった」と書きました。容量を減らす意味はメモリに載せるためであって、速度のためではない、という話です。今回はその裏返しで、載せられるなら削らないほうがよいことがはっきりしました。
資料に書かれていた挙動を、実物で確認した
Qwen3.8-Flash-Nextだけ、少し変わった結果が出ています。ファイルは83.80 GiBあるのに、VRAM使用量は57.6 GiBでした。すべてGPUに載せる指定をしているにもかかわらず、26 GiB分が載っていません。
これはMoEと量子化でLLMの必要メモリが変化、VRAMとホストRAMを分けて見る必要にで触れた、51BのN-gram埋め込みだと考えられます。あの記事ではvLLMの公式レシピが「この部分をホストRAMへ非同期でオフロードする前提になっている」と資料から書きました。llama.cppでも同じことが起きているように見えます。資料で読んだ挙動を、実物で裏づけられたことになります。
そしてこの構成が3モデルの中でいちばん速く、VRAMの余裕も最大でした。逃がすべき部分を選んで逃がせば、速度を落とさずに容量を空けられる、ということです。今回測った「エキスパートを層ごとに逃がす」やり方とは、質が違います。
動かすまでに越える壁
3つのモデルは、実行系の対応状況がそれぞれ違いました。
| モデル | llama.cpp の対応 |
|---|---|
| DeepSeek-V4-Flash-0731 | 本流でそのまま動く |
| Qwen3.8-Flash-Next | 本流に無し。Unslothの未マージPR(#27742)が要る |
| GLM-5.3-Flash | 本流に無し。PRが3本競合して未マージ。Unslothは#27754を採用 |
当サイトでは本流のソースを直接引いて、この3つの名前が入っているかを確認しました。そのうえでllama.cppを3種類ビルドし分けています。GLM-5.3-Flashは公式重みの公開翌日にGGUF版が出ていますが、本流に取り込まれるまでは、誰かのフォークを信じて使うことになります。
なおRTX PRO 6000はBlackwellという世代で、ビルドにCUDA 12.8以上と、GPUの型番の指定が要ります。ここは前回と同じです。
まとめ
VRAMに全部載るなら、300B級でも毎秒67トークン出ます。読む速さのおよそ10倍以上で、待たされる感覚はありません。
一方で、ほんの少し足りないのがいちばん悪いという結果になりました。4層逃がすだけで速度は半分以下、そのときVRAMは1.3 GiBしか浮きません。「削って詰め込む」より「載る大きさを選ぶ」ほうが、速度でも品質でも有利です。
必要なメモリの考え方についてはMoEと量子化でLLMの必要メモリが変化、VRAMとホストRAMを分けて見る必要に、毎秒何トークンあれば読む速さに足りるかについてはRTX 3090でLLMを実測―毎秒何トークンあれば読む速さに足りるかもあわせてご覧ください。


